Völlig vermessen: Was wir über KI-Kompetenz von Studierenden und Lehrenden zu wissen glauben.
Forscher messen die KI-Kompetenz an Hochschulen meist mit Fragebögen. Nur leider zeichnen die oft ein besseres Bild als eine richtige Messung, allein schon, weil es sozial erwünschte Antworten gibt.
Wo Informationskompetenz z.B. technisch erfasst wird, fallen die Ergebnisse meist deutlich schlechter aus. Das war schon vor KI so, aber die Bildungsforschung hat daraus anscheinend nichts gelernt. Die Differenz zwischen Selbstauskunft und Verhalten, geglaubtem und tatsächlichem Wissen ist gewachsen.
Hier die meines Erachtens wichtigsten Probleme und Punkte.
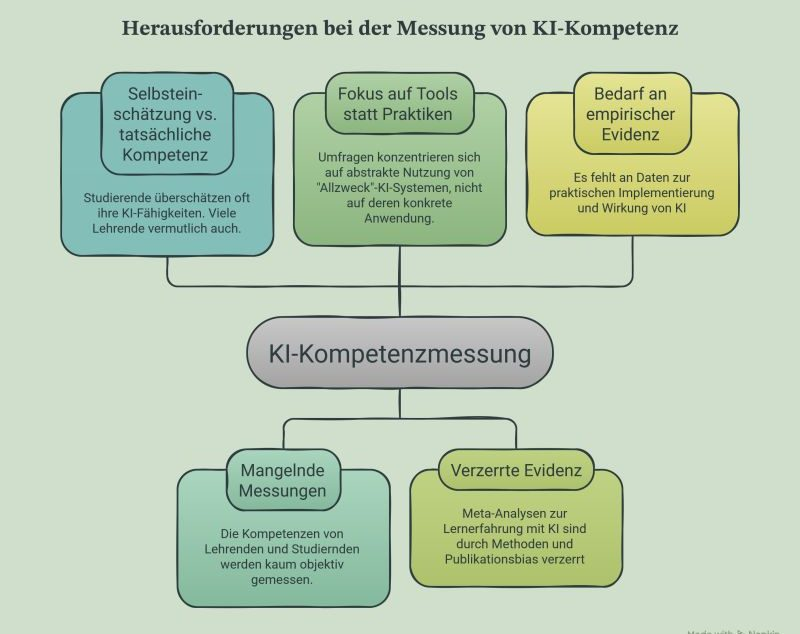
Fünf Probleme bei der Messung von KI-Kompetenz
1.) Bei vielen Studierenden besteht eine große Diskrepanz zwischen Selbsteinschätzung und tatsächlicher KI-Kompetenz. Zwar fühlen sie sich gut über KI informiert, aber: „Weitergehende Wissensmessungen zeigen allerdings deutliche und systematische Lücken, vor allem bei technologisch-technischen Aspekten und komplexeren Funktionsprinzipien." ( Bosse, Wannemacher und Lübcke 2026) Das Problem: "Nur vereinzelt kommen objektive Wissenstests zum Einsatz." ( Münzer, Go, Paaßen, 2026)
KI-Kompetenz an Hochschulen: Die Forscher messen vor allem, was Studierende über sich selbst glauben. Die Daten verdecken mehr als sie zeigen.
2.) Bei den Lehrenden sieht es ähnlich aus. Es liegen fast nur Selbsteinschätzungen vor, es gibt kaum echte Messungen. Wenn sie dann doch mal gemacht werden, sieht das Ergebnis so aus: Über 5.000 Forscher aus Deutschland bekamen eine Prompting-Aufgabe. Nur 21 % konnten sie erfolgreich absolvieren. (Chugunova et al. 2026)
3.) Die Studien zeigen, welche KI-Systeme genutzt werden und wofür. Nicht, wie damit gearbeitet wird, d.h. wie Anfragen formuliert werden, ob und wie oft Quellen geöffnet und Antworten geprüft werden, ob irgendwas außerhalb von ChatGPT, Gemini und Claude zum Einsatz kommt. Es ist bezeichnend, dass es in der mit über 6.000 Teilnehmern bisher größten Umfrage zur KI-Nutzung unter deutschen Wissenschaftlern heißt: „we chose not to elicit specific tools used by researchers. As a result, our findings reflect aggregated experiences across a diverse set of AI tools, rather than tool-specific assessments." ( Chugunova et al. 2026)
4.) Die Evidenzen halten nicht: 67 Meta-Analysen zur Lernwirkung von KI, geprüft in einer Meta-Meta-Analyse. Ergebnis: Die Befunde der bisherigen Analysen sind verzerrt, weil die verwendeten Methoden nicht passen, weil Berichte über Effektstärken fehlen und weil positive Ergebnisse häufiger eingereicht und zitiert werden. ( Bartoš et al. 2026)
5.) Es gibt „dringenden Bedarf an empirischer Evidenz und theoretischer Einordnung der praktischen Implementierung generativer KI-Anwendungen in realen Bildungssituationen, einschließlich der Rolle der Lehrperson, der tatsächlichen Nutzungspraktiken der Lernenden über die Zeit sowie der Frage, ob Wirkungen über Neuheitseffekte hinaus und jenseits tool-gestützter Performanz bestehen bleiben." ( Wissenschaftsrat 2026)
Es wäre dringend an der Zeit, diese Daten zu erheben und endlich Wirkungen statt Wunschvorstellungen zu messen.