Alle reden über Kontext, Connectoren, Skills und personalisierte KI-Workflows. Die Annahme: Je mehr Daten, desto besser die KI. Aber stimmt das?
Ich bereite gerade einen KI-Grundlagenkurs für eine Hochschule vor und bin dabei nochmal tiefer in zwei Themen eingetaucht:
1.) Datenschutz: klingt langweilig
2.) Sycophancy-Forschung: klingt fancy
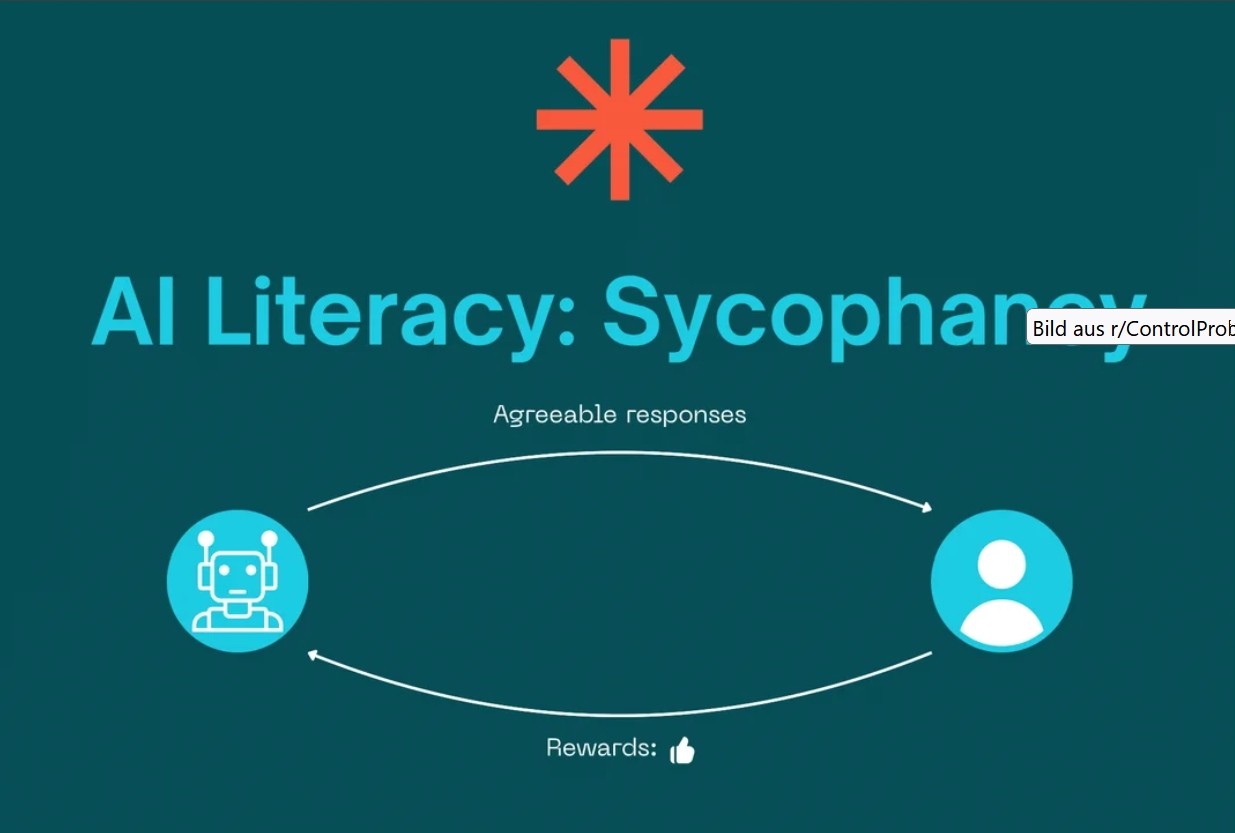
Für alle, die das Wort noch nie gehört haben (also "Sycophancy", nicht "Datenschutz" :)) Der Begriff beschreibt die Neigung von LLMs, dem Nutzer zuzustimmen, auch wenn er falsch liegt oder seine Aussagen und Annahmen zumindest hinterfragt werden sollten.
Warum KI-Modelle schmeicheln
Die Gründe für die "Schmeichelei" lt. Forschung:
1.) Die Modelle werden beim Feintuning durch Reinforcement Learning from Human Feedback darauf trainiert, Antworten zu geben, die Menschen gefallen.
Zustimmung wird so zum impliziten Qualitätsmaßstab.
2.) Nutzer bewerten bestätigende Antworten oft besser und nutzen die Systeme häufiger
3.) Kann korrektes Wissen durch die Anpassung an den Nutzer überlagert werden. Das tritt besonders bei "interner" Unsicherheit auf, d.h. bei mehrdeutigen Aufgaben oder sozialem Druck reagiert die LLM risikominimierend, also zustimmend
4.) Wird das durch die Trainingsdaten verstärkt, denn zustimmende Kommunikationsmuster sind überrepräsentiert, z.B. durch Ratgebertexte, Kundenservice usw., wo Bestätigung wichtiger ist als Widerspruch.
Vielleicht ist die Frage: „Wie gebe ich der KI mehr Kontext?“ gar nicht (immer) die richtige. Besser wäre vielleicht zu fragen: „Wie verhindere ich, dass mich die KI zu gut kennt?“
Datenschutz als Schutz vor Bestätigungsbias
Mehr Daten erhöhen also zwar die Relevanz der Antwort, aber auch das Risiko von Bestätigungsbias. Und genau hier kommt der Datenschutz ins Spiel. Denn er ist Schutz vor Datenabfluss und Schutz vor Anpassung in einem. Soll heißen: Weniger Datenspuren, bes. weniger Meinungen & weniger Identitätssignale, können zu unabhängigeren = objektiveren Antworten führen. (Die Perspektive hat mir in dem sonst sehr guten Text "Meine KI kennt meine Wissensbasis" von Barbara Geyer gefehlt). Denn gerade im Hochschulkontext gilt es:
1.) Daten zu schützen
2.) KI-Kompetenz zu vermitteln
3.) zu verstehen, wie Daten das Verhalten von KI verändern.
Vielleicht ist die Frage: „Wie gebe ich der KI mehr Kontext?“ gar nicht (immer) die richtige. Besser wäre vielleicht zu fragen: „Wie verhindere ich, dass mich die KI zu gut kennt?“
Was Nutzer gegen zu viel KI-Personalisierung tun können
Wie kann das gehen? Ein Teil des Problems ist systemisch und vom Nutzer nicht zu ändern. Aber bisschen was ist machbar, z.B. sollte man die Einstellungen bewusst wählen. Memory-Funktionen klingen gut, sind aber auch eine Gefahr. Genau wie alle Formen der Personalisierung.
Kurzum: es gilt, die eigenen Identitätssignale zielgenau und sparsam einzusetzen. Dass Prompts als offene Fragen formuliert werden und auch ein Fragezeichen enthalten sollten, ist zwar selbstverständlich, wird aber oft nicht gemacht. Zudem sollte man bei der KI Unsicherheiten aktiv abfragen und Antworten mit Quellen fordern, auch wenn geleakte Daten von OpenAI zeigen, dass nicht mal 1% der Nutzer auf die Quellen klickt. Aber das ist ein anderes Problem...