Statistik für Menschen, die Statistik eigentlich meiden (Teil 3 von 4)
Statistik hatte bisher ein Imageproblem. Sie galt als knochentrocken und kompliziert, der Horror für Geisteswissenschaftler, Medienmacher & Marketingleute.
KI-Tools versprechen Abhilfe
In diese Lücke stoßen KI-Tools wie julius.ai, excelmatic.ai und Co und versprechen Abhilfe. Und auf der Oberfläche der Ergebnisse liefern sie auch: statistische Analysen, Grafiken, Auswertungen. Doch je bequemer die Statistik wird, desto größer wird die Versuchung, sie nicht mehr verstehen zu müssen. Nicht Deskilling, sondern Gar-nicht-erst-Upskilling. Das ist ein generelles Problem, das KI in Hochschulen erzeugt.
Bisher scheitert Statistik jedenfalls nicht nur an fehlenden Mathekenntnissen, sondern auch und vor allem an Einstellungen und an der Frage, wozu um alles in der Welt man sich das antun soll. Und diese Frage stellen sich vor allem Geisteswissenschaftler, Medienmacher und Marketingleute.
Was die Forschung zur Statistik-Angst zeigt
Eine aktuelle Meta-Analyse (s.u.) von 29 Studien mit 5.000 Teilnehmern zeigt: klassische Statistikkurse bringen nichts. Die Leute lernen ein bisschen Statistik, bekommen dafür einen Schein – und ignorieren das Gelernte danach so lange, bis sie alles wieder vergessen haben. Oder sie können es in Studium und Beruf nicht anwenden, was denselben Effekt hat.
Das zeigt sich vor allem in den Geistes- und Gesundheitswissenschaften, also genau dort, wo Statistik oft kaum Platz hat und als modernes Übel gilt. Und warum: Weil der Mehraufwand als zu hoch empfunden wird im Vergleich mit dem, was dabei rauskommt.
Automation Bias und die Blackbox-Gefahr
Und genau da kommen die KI-Tools ins Spiel, denn Statistik wird damit scheinbar leicht. Doch ein Risiko bleibt, denn das Verständnis für Zahlen und Analysen wächst nicht. Mehr noch: der Automation Bias greift jetzt. Heißt: Menschen tendieren dazu, automatisierten Systemen übermäßig stark zu vertrauen. Was die Statistik-KIs sagen klingt super, scheint rund, sieht dazu noch grafisch gut aus. Wird also stimmen.
Tut es in den meisten Fällen auch. Aber in welchen nicht? Wie kann man das prüfen, wenn man keine Ahnung von der Materie hat? Indem man die Ergebnisse mehrerer Tools miteinander vergleicht? Das wäre ein Ansatz, aber wer macht das? Kaum jemand.
Ein weiteres Risiko betrifft den Code unter der Haube: die Black Box, die wir alle immer vergessen. KI-gestützte Statistiktools generieren intern Python- u.a. Code. Aber machen sie das auch gut? Für julius.ai zeigen Studien, dass es funktioniert. (siehe Teil 2) Bei anderen Tools fehlen diese Daten noch.
Wie also weiter? Und was generell tun? Darum wird's im vierten und letzten Teil gehen.
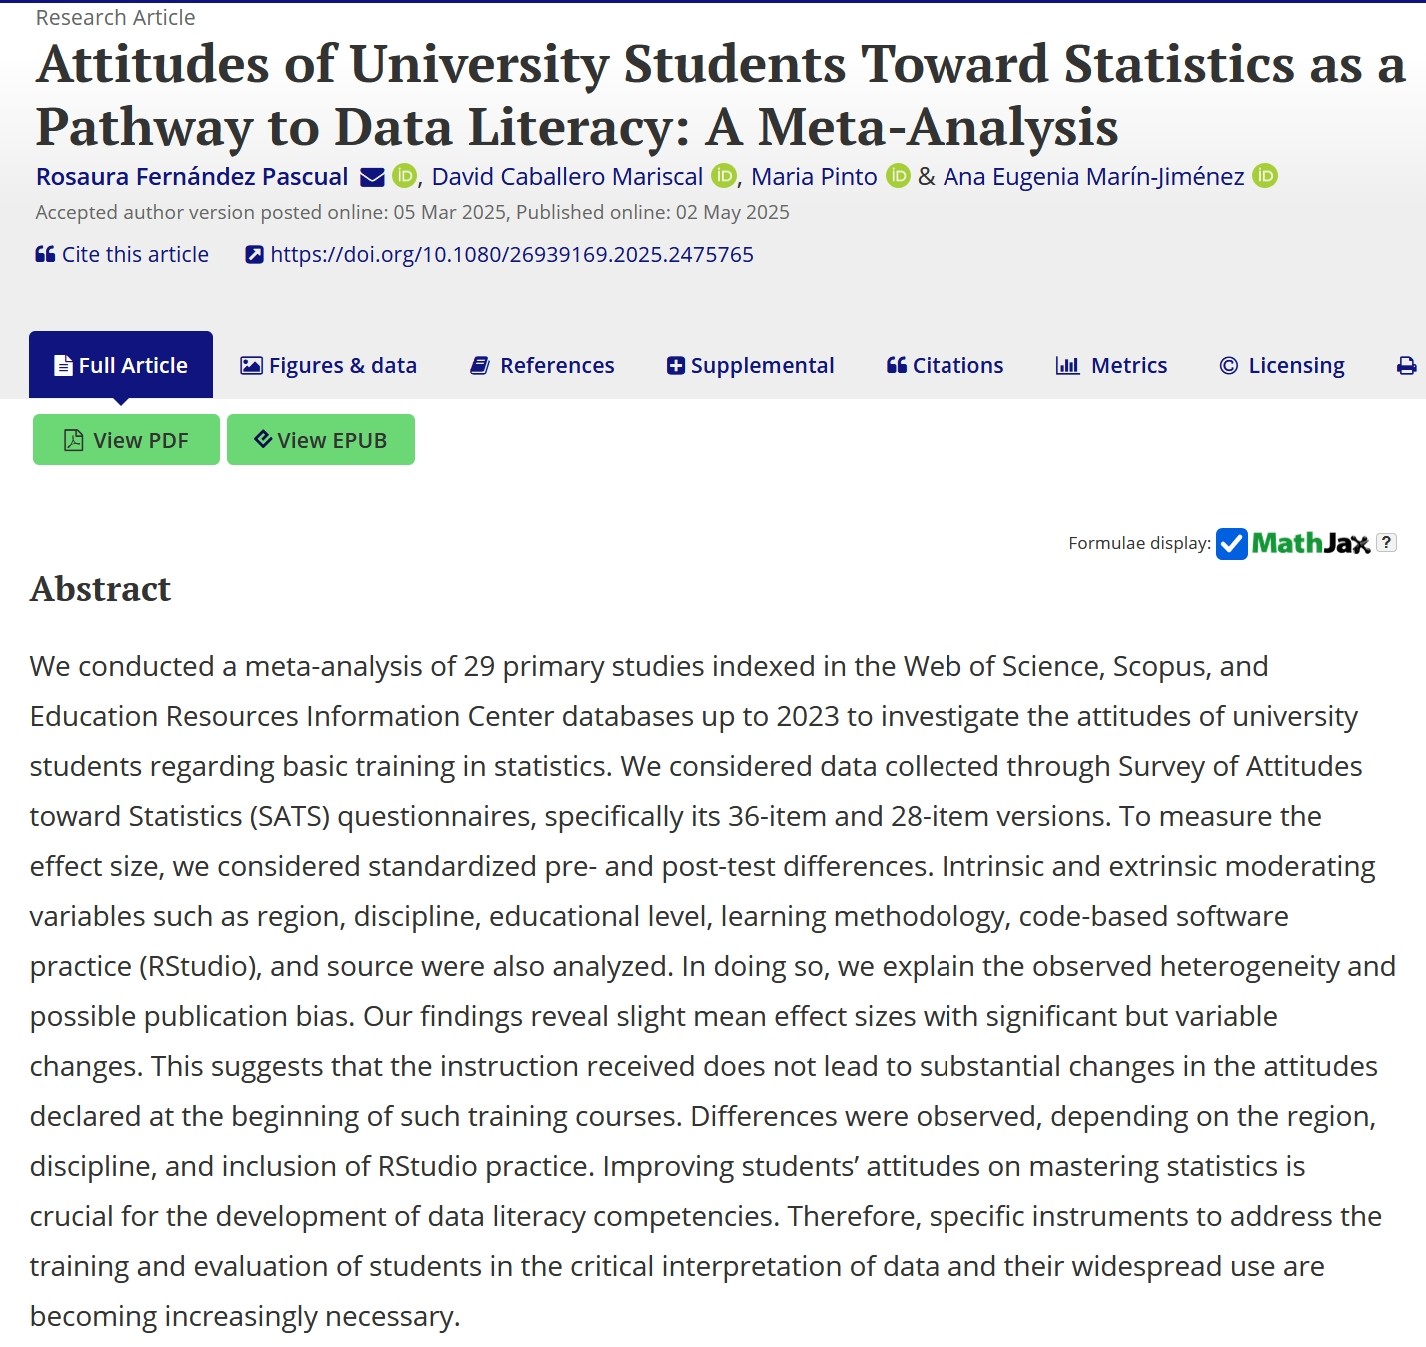
Quelle: Pascual et al. (2025). Attitudes of University Students Toward Statistics as a Pathway to Data Literacy: A Meta-Analysis. Journal of Statistics and Data Science Education, 1-18.